MENU

martes, 29 de marzo de 2016


INTERFAZ GRÁFICO DE  COMANDO (G.U.I)

uLa interfaz gráfica de usuario, conocida también como GUI , es un programa informático que actúa de interfaz de usuario, utilizando un conjunto de imágenes y objetos gráficos para representar la información y acciones disponibles en la interfaz. Su principal uso, consiste en proporcionar un entorno visual sencillo para permitir la comunicación con el sistema operativo de una máquina o computador.

TIPOS DE INTERFAZ DE USUARIO 

uINTERFAZ DE LÍNEA DE COMANDO (C.L.I)

uLas CLI pueden emplearse interactiva mente, escribiendo instrucciones en alguna especie de entrada de texto, o pueden utilizarse de una forma mucho más automatizada (archivo batch), leyendo órdenes desde un archivo de scripts.

uEsta interfaz existe casi desde los comienzos de la computación, superada en antigüedad solo por las tarjetas perforadas y mecanismos similares. Existen para diversos programas y sistemas operativos, para diverso hardware, y con distinta funcionalidad


EJEMPLOS INCORRECTOS 


EJEMPLOS CORRECTOS 


OBJETIVOS DEL INTERFAZ DE USUARIO


uDebemos tener siempre como objetivo crear una interfaz sencilla que pueda ser utilizada de manera intuitiva.

uCuantos menos manuales de instrucciones tengan que leer nuestros usuarios, mejor que mejor. 

uOrden, jerarquía y metáforas visuales son algunos de los elementos que nos ayudarán a clarificar las funciones de nuestro producto o servicio

lunes, 21 de marzo de 2016


PRINCIPIOS DE DISEÑO IU

Familiaridad del usuario:
La interfaz debe utilizar  términos y conceptos obtenidos de la experiencia de las personas que más utilizan en el sistema

Uniformidad: 
Siempre que sea posible, la interfaz debe ser uniforme en el sentido de que las operaciones comparables se activen de la misma forma

 Mínimas sorpresa:
El comportamiento del sistema no debe provocar sorpresa al usuario

Guía del usuario:
Cuando ocurren errores, la interfaz debe proporcionar retroalimentación significativa y características debe ayudar sensible al contexto

Diversidad de usuario:
La interfaz debe proporcionas características de interfaz apropiada para los diferentes tipos de usuario del sistema  

QUE ES EL DISEÑO IU

El diseño de interfaz de usuario o ingeniería de la interfaz es el diseño de computadoras, aplicaciones, máquinas, dispositivos de comunicación móvil, aplicaciones de software, y sitios web enfocado en la experiencia de usuario y la interacción.
 Normalmente es una actividad multidisciplinario que involucra a varias ramas es decir al diseño y el conocimiento como el diseño gráfico, industrial, web, de software y la economía; y está implicado en un amplio rango de proyectos, desde sistemas para computadoras, vehículos hasta aviones comerciales.

jueves, 25 de febrero de 2016


INTERFAZ DE USUARIO

          La interfaz de usuario es el medio con que el usuario puede comunicarse con una máquina, equipo, computadora o dispositivo, y comprende todos los puntos de contacto entre el usuario y el equipo.
         Normalmente suelen ser fáciles de entender y fáciles de accionar, aunque en el ámbito de la informática es preferible referirse a que suelen ser "amigables e intuitivos" porque es complejo y subjetivo decir "fácil".
         Las interfaces básicas de usuario son aquellas que incluyen elementos como menús, ventanas, contenido gráfico, cursor, los beeps y algunos otros sonidos que la computadora hace, y en general, todos aquellos canales por los cuales se permite la comunicación entre el ser humano y la computadora.
         La mejor interacción humano-máquina a través de una adecuada interfaz (de usuario), que le brinde tanto comodidad, como eficiencia.

         https://es.wikipedia.org/wiki/Interfaz_de_usuario

lunes, 21 de diciembre de 2015

Tercera nacionalización 

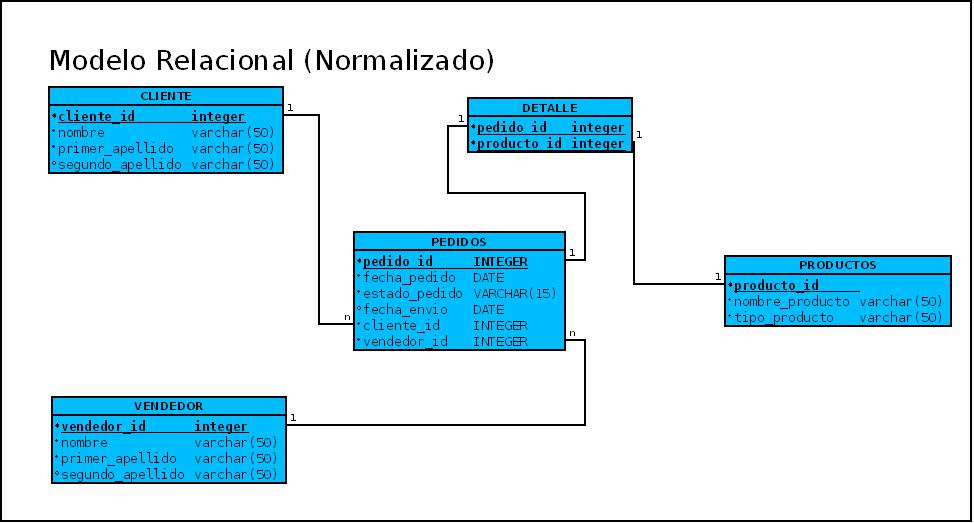
Tercera Forma Normal Una tabla está normalizada en esta forma si todas las columnas que no son llave son funcional mente dependientes por completo de la llave primaria y no hay dependencias transitivas. Comentamos anteriormente que una dependencia transitiva es aquella en la cual existen columnas que no son llave que dependen de otras columnas que tampoco son llave. Cuando las tablas están en la Tercera Forma Normal se previenen errores de lógica cuando se insertan o borran registros. Cada columna en una tabla está identificada de manera única por la llave primaria, y no deben haber datos repetidos. Esto provee un esquema limpio y elegante, que es fácil de trabajar y expandir. Un dato sin normalizar no cumple con ninguna regla de nacionalización. Para explicar con un ejemplo en que consiste cada una de las reglas, vamos a considerar los datos de la siguiente tabla.


Segunda nacionalización

Segunda Forma Normal La regla de la Segunda Forma Normal establece que todas las dependencias parciales se deben eliminar y separar dentro de sus propias tablas. Una dependencia parcial es un término que describe a aquellos datos que no dependen de la llave primaria de la tabla para identificarlos. Una vez alcanzado el nivel de la Segunda Forma Normal, se controlan la mayoría de los problemas de lógica. Podemos insertar un registro sin un exceso de datos en la mayoría de las tablas.


Primera Norma

En la tabla siguiente se describe breve mente en que consiste cada una de las reglas, y posteriormente se explican con más detalle.
(1FN) Incluye la eliminación de todos los grupos repetidos. Segunda Forma Normal 
(2FN) Asegura que todas las columnas que no son llave sean completamente dependientes de la llave primaria (PK). Tercera Forma Normal
 (3FN) Elimina cualquier dependencia transitiva. Una dependencia transitiva es aquella en la cual las columnas que no son llave son dependientes de otras columnas que tampoco son llave.
Primera Forma Normal La regla de la Primera Forma Normal establece que las columnas repetidas deben eliminarse y colocarse en tablas separadas.
Poner la base de datos en la Primera Forma Normal resuelve el problema de los encabezados de columna múltiples. Muy a menudo, los diseñadores de bases de datos inexpertos harán algo similar a la tabla no normalizada. Una y otra vez, crearán columnas que representen los mismos datos. La nacionalización ayuda a clarificar la base de datos y a organizarla en partes más pequeñas y más fáciles de entender. En lugar de tener que entender una tabla gigantesca y monolítica que tiene muchos diferentes aspectos, sólo tenemos que entender los objetos pequeños y más tangibles, así como las relaciones que guardan con otros objetos también pequeños.


NORMALIZACIÓN DE BASE DE DATOS 

La normalización es el proceso mediante el cual se transforman datos complejos a un conjunto de estructuras de datos más pequeñas, que además de ser más simples y más estables, son más fáciles de mantener. También se puede entender la nacionalización como una serie de reglas que sirven para ayudar a los diseñadores de bases de datos a desarrollar un esquema que minimice los problemas de lógica. Cada regla está basada en la que le antecede. La nacionalización se adoptó porque el viejo estilo de poner todos los datos en un solo lugar, como un archivo o una tabla de la base de datos, era ineficiente y conducía a errores de lógica cuando se trataban de manipular los datos. La nacionalización también hace las cosas fáciles de entender. Los seres humanos tenemos la tendencia de simplificar las cosas al máximo. Lo hacemos con casi todo, desde los animales hasta con los automóviles. Vemos una imagen de gran tamaño y la hacemos más simple agrupando cosas similares juntas. Las guías que la nacionalización provee crean el marco de referencia para simplificar una estructura de datos compleja. Otra ventaja de la nacionalización de base de datos es el consumo de espacio. Una base de datos normalizada ocupa menos espacio en disco que una no normalizada. Hay menos repetición de datos, lo que tiene como consecuencia un mucho menor uso de espacio en disco. El proceso de nacionalización tiene un nombre y una serie de reglas para cada fase. Esto puede parecer un poco confuso al principio, pero poco a poco se va entendiendo el proceso, así como las razones para hacerlo de esta manera

http://www.eet2mdp.edu.ar/alumnos/MATERIAL/MATERIAL/info/infonorma.pdf

martes, 15 de diciembre de 2015

 RED

El argumento principal a favor del modelo de red, en comparación con el modelo jerárquico, era que permitió un modelado más natural de relaciones entre entidades. Aunque el modelo extensamente fuera puesto en práctica y usado, esto falló en hacerse dominante por dos motivos principales. En primer lugar, la IBM decidió atenerse al modelo jerárquico con extensiones de semired en sus productos establecidos como IMS Y DL/I. En segundo lugar, eventualmente fue desplazado por el modelo relacional, que ofreció un nivel más alto, la interfaz más declarativo. Hasta principios de los años 1980 las ventajas del funcionamiento de las interfaces de bajo nivel de navegación ofrecidos por jerárquico y bases de datos de red eran persuasivas para muchos usos en gran escala, pero como el hardware se hizo más rápido, la productividad suplementaria y la flexibilidad del modelo relacional condujo a la caída en desuso gradual del modelo de red en el uso corporativo de la empresa.


https://es.wikipedia.org/wiki/Modelo_de_red


RELACIONAL 

El modelo relacional, para el modelado y la gestión de bases de datos, es un modelo de datos basado en la lógica de predicados y en la teoría de conjuntos.
Tras ser postuladas sus bases en 1970 por Edgar Frank Codd, de los laboratorios IBM en San José (California), no tardó en consolidarse como un nuevo paradigma en los modelos de base de datos.
Su idea fundamental es el uso de relaciones. Estas relaciones podrían considerarse en forma lógica como conjuntos de datos llamados tuplas. Pese a que esta es la teoría de las bases de datos relacionales creadas por Codd, la mayoría de las veces se conceptualiza de una manera más fácil de imaginar, pensando en cada relación como si fuese una tabla que está compuesta por registros (cada fila de la tabla sería un registro o "tupla") y columnas (también llamadas "campos").
Es el modelo más utilizado en la actualidad para modelar problemas reales y administrar datos dinámicamente.
https://es.wikipedia.org/wiki/Modelo_relacional

Jerárquicas

En ellas se organiza la información se organiza con un jerarquía en la que la relación entre las entidades de este modelo siempre es del tipo padre / hijo. De esta forma hay una serie de nodos que contendrán atributos y que se relacionarán con nodos hijos de forma que puede haber más de un hijo para el mismo padre (pero un hijo sólo tiene un padre).
Las entidades de este modelo se llaman 
Las entidades de este modelo se llaman segmentos y los atributos campos. La forma visual de este modelo es de árbol invertido, en la parte superior están los padres y en la inferior los hijos.

Modelos lógicos de datos

Un modelo de datos es un lenguaje orientado a hablar de una Base de Datos. Típicamente un modelo de datos permite describir:
  • Las estructuras de datos de la base: El tipo de los datos que hay en la base y la forma en que se relacionan.
  • Operaciones de manipulación de los datos: típicamente, operaciones de agregado, borrado, modificación y recuperación de los datos de la base.
Otro enfoque es pensar que un modelo de datos permite describir los elementos de la realidad que intervienen en un problema dado y la forma en que se relacionan esos elementos entre sí.
No hay que perder de vista que una Base de Datos siempre está orientada a resolver un problema determinado, por lo que los dos enfoques propuestos son necesarios en cualquier desarrollo de software.


LA PROTECCIÓN DE DATOS

La protección de datos personales se ubica dentro del campo de estudio del Derecho Informático. Se trata de la garantía o la facultad de control de la propia información frente a su tratamiento automatizado o no, es decir, no sólo a aquella información albergada en sistemas comunicacionales, sino en cualquier soporte que permita su utilización: almacenamiento, organización y acceso. En algunos países la protección de datos encuentra reconocimiento constitucional, como derecho humano y en otros simplemente legal.

EL ADMINISTRADOR DE BASE DE DATOS 

Un administrador de bases de datos (también conocido como DBA, en inglés database administrador) es aquel profesional que administra las tecnologías de la información y la comunicación, siendo responsable de los aspectos técnicos, tecnológicos, científicos, inteligencia de negocios y legales de bases de datos.
Sus tareas incluyen las siguientes:
  • Implementar, dar soporte y gestionar bases de datos corporativas.
  • Crear y configurar bases de datos relacionales.
  • Ser responsables de la integridad de los datos y la disponibilidad.
  • Diseñar, desplegar y monitorizar servidores de bases de datos.
  • Diseñar la distribución de los datos y las soluciones de almacenamiento.
  • Garantizar la seguridad de las bases de datos, realizar copias de seguridad y llevar a cabo la recuperación de desastres.
  • Planificar e implementar el aprovisionamiento de los datos y aplicaciones.
  • Diseñar planes de contingencia.
  • Diseñar y crear las bases de datos corporativas de soluciones avanzadas.
  • Analizar y reportar datos corporativos que ayuden a la toma de decisiones en la inteligencia de negocios.
  • Producir diagramas de entidades relacionales y diagramas de flujos de datos, normalización esquemática, localización lógica y física de bases de datos y parámetros de tablas.
Los administradores de bases de datos tienen competencias y capacidades en uno o más sistemas de gestión de bases de datos, algunos ejemplos: Microsoft SQL Server, IBM DB2, Oracle MySQL, Oracle database, IBM Informix y SQL Anywhere.
En ingeniería estadística es una de las cualificaciones subyacentes, que trata la información para almacenarla, hacerla altamente explotable y altamente disponible. Además, vela por la eficacia técnológica del almacenamiento en el desempeño de investigaciones, buscando inferencias sólidas y compactas, para canalizar resultados manteniendo un equilibrio entre las ciencias involucradas y la propiamente enunciada, ingeniería estadística de las ciencias de la computación.
https://es.wikipedia.org/wiki/Administrador_de_base_de_datos


EL DICCIONARIO DE RECURSOS DE INFORMACIÓN

RECURSOS DE INFORMACIÓN                     EJE N 2         YENNYFER LORENA GUZMAN MARTIN          PAULA ANDREA MONTOYA AG...

http://es.slideshare.net/marytotu/unidad-2-recursos-de-informacion


BASE DE DATOS DISTRIBUIDAS 

Una base de datos distribuida (BDD) es un conjunto de múltiples bases de datos lógicamente relacionadas las cuales se encuentran distribuidas en diferentes espacios lógicos y geográficos (pej. un servidor corriendo 2 máquinas virtuales) e interceptados por una red de comunicaciones. Dichas BDD tienen la capacidad de realizar procesamiento autónomo, esto permite realizar operaciones locales o distribuidas. Un sistema de Bases de Datos Distribuida (SBDD) es un sistema en el cual múltiples sitios de bases de datos están ligados por un sistema de comunicaciones de tal forma que, un usuario en cualquier sitio puede acceder los datos en cualquier parte de la red exactamente como si estos fueran accedidos de forma local.
Un sistema distribuido de bases de datos se almacenan en varias computadoras. Los principales factores que distinguen un SBDD de un sistema centralizado son los siguientes:
  • Hay múltiples computadores, llamados sitios o nodos.
  • Estos nodos deben de estar comunicados por medio de algún tipo de red de comunicaciones para transmitir datos y órdenes entre los sitios.
https://es.wikipedia.org/wiki/Bases_de_datos_distribuidas