Tercera nacionalización
MENU
- INICIO
- MATERIA
- CICLO DE VIDA DE UN SISTEMA DE INFORMACION
- METODOLOGÍAS DE DESARROLLO DEL SOFTWARE
- METODOLOGÍAS ORIENTADOS A OBJETOS
- METODOLOGÍAS MIXTAS DE LAS ADMINISTRACIONES
- SE DIVIDE EN:
- METODOLOGÍAS PARA SISTEMAS DE TIEMPO REAL
- METODOLOGÍAS ÁGILES
- Pestaña 2.2.1
- Pestaña 2.2.2
- Pestaña 2.2.3
- Pestaña 2.2.4
- Pestaña 2.2.5
- Pestaña 2.2.6
lunes, 21 de diciembre de 2015
Segunda nacionalización
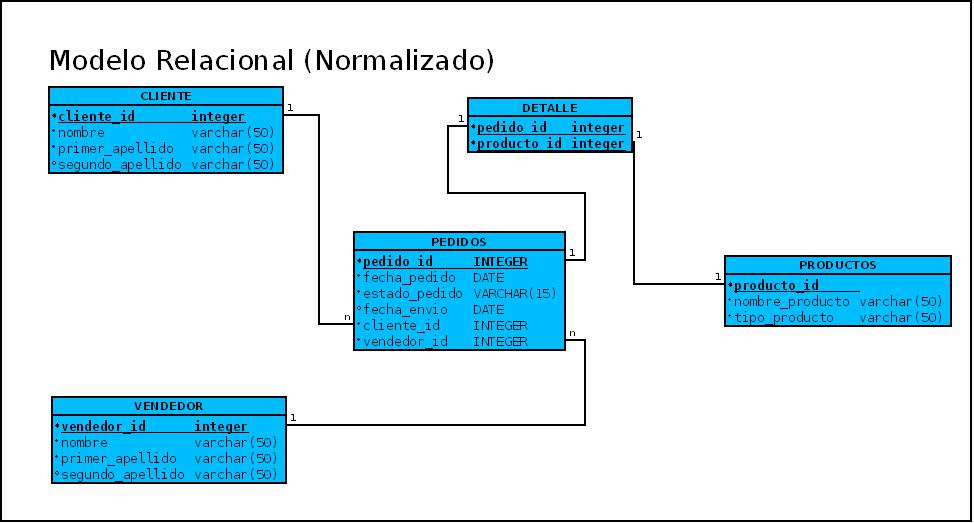
Segunda Forma Normal La regla de la Segunda Forma Normal establece que todas las dependencias parciales se deben eliminar y separar dentro de sus propias tablas. Una dependencia parcial es un término que describe a aquellos datos que no dependen de la llave primaria de la tabla para identificarlos. Una vez alcanzado el nivel de la Segunda Forma Normal, se controlan la mayoría de los problemas de lógica. Podemos insertar un registro sin un exceso de datos en la mayoría de las tablas.
Primera Norma
En la tabla siguiente se describe breve mente en que consiste cada una de las reglas, y posteriormente se explican con más detalle.
(1FN) Incluye la eliminación de todos los grupos repetidos. Segunda Forma Normal
(2FN) Asegura que todas las columnas que no son llave sean completamente dependientes de la llave primaria (PK). Tercera Forma Normal
(3FN) Elimina cualquier dependencia transitiva. Una dependencia transitiva es aquella en la cual las columnas que no son llave son dependientes de otras columnas que tampoco son llave.
Primera Forma Normal La regla de la Primera Forma Normal establece que las columnas repetidas deben eliminarse y colocarse en tablas separadas.
Poner la base de datos en la Primera Forma Normal resuelve el problema de los encabezados de columna múltiples. Muy a menudo, los diseñadores de bases de datos inexpertos harán algo similar a la tabla no normalizada. Una y otra vez, crearán columnas que representen los mismos datos. La nacionalización ayuda a clarificar la base de datos y a organizarla en partes más pequeñas y más fáciles de entender. En lugar de tener que entender una tabla gigantesca y monolítica que tiene muchos diferentes aspectos, sólo tenemos que entender los objetos pequeños y más tangibles, así como las relaciones que guardan con otros objetos también pequeños.
NORMALIZACIÓN DE BASE DE DATOS
La normalización es el proceso mediante el cual se transforman datos complejos a un conjunto de
estructuras de datos más pequeñas, que además de ser más simples y más estables, son más
fáciles de mantener. También se puede entender la nacionalización como una serie de reglas que sirven
para ayudar a los diseñadores de bases de datos a desarrollar un esquema que minimice los
problemas de lógica. Cada regla está basada en la que le antecede. La nacionalización se adoptó porque el
viejo estilo de poner todos los datos en un solo lugar, como un archivo o una tabla de la base de datos,
era ineficiente y conducía a errores de lógica cuando se trataban de manipular los datos.
La nacionalización también hace las cosas fáciles de entender. Los seres humanos tenemos la tendencia
de simplificar las cosas al máximo. Lo hacemos con casi todo, desde los animales hasta con los
automóviles. Vemos una imagen de gran tamaño y la hacemos más simple agrupando cosas similares
juntas. Las guías que la nacionalización provee crean el marco de referencia para simplificar una estructura
de datos compleja.
Otra ventaja de la nacionalización de base de datos es el consumo de espacio. Una base de datos
normalizada ocupa menos espacio en disco que una no normalizada. Hay menos repetición de datos, lo
que tiene como consecuencia un mucho menor uso de espacio en disco.
El proceso de nacionalización tiene un nombre y una serie de reglas para cada fase. Esto puede parecer
un poco confuso al principio, pero poco a poco se va entendiendo el proceso, así como las razones para
hacerlo de esta manera
http://www.eet2mdp.edu.ar/alumnos/MATERIAL/MATERIAL/info/infonorma.pdf
martes, 15 de diciembre de 2015
RED
El argumento principal a favor del modelo de red, en comparación con el modelo jerárquico, era que permitió un modelado más natural de relaciones entre entidades. Aunque el modelo extensamente fuera puesto en práctica y usado, esto falló en hacerse dominante por dos motivos principales. En primer lugar, la IBM decidió atenerse al modelo jerárquico con extensiones de semired en sus productos establecidos como IMS Y DL/I. En segundo lugar, eventualmente fue desplazado por el modelo relacional, que ofreció un nivel más alto, la interfaz más declarativo. Hasta principios de los años 1980 las ventajas del funcionamiento de las interfaces de bajo nivel de navegación ofrecidos por jerárquico y bases de datos de red eran persuasivas para muchos usos en gran escala, pero como el hardware se hizo más rápido, la productividad suplementaria y la flexibilidad del modelo relacional condujo a la caída en desuso gradual del modelo de red en el uso corporativo de la empresa.
https://es.wikipedia.org/wiki/Modelo_de_red
RELACIONAL
El modelo relacional, para el modelado y la gestión de bases de datos, es un modelo de datos basado en la lógica de predicados y en la teoría de conjuntos.
Tras ser postuladas sus bases en 1970 por Edgar Frank Codd, de los laboratorios IBM en San José (California), no tardó en consolidarse como un nuevo paradigma en los modelos de base de datos.
Su idea fundamental es el uso de relaciones. Estas relaciones podrían considerarse en forma lógica como conjuntos de datos llamados tuplas. Pese a que esta es la teoría de las bases de datos relacionales creadas por Codd, la mayoría de las veces se conceptualiza de una manera más fácil de imaginar, pensando en cada relación como si fuese una tabla que está compuesta por registros (cada fila de la tabla sería un registro o "tupla") y columnas (también llamadas "campos").
Es el modelo más utilizado en la actualidad para modelar problemas reales y administrar datos dinámicamente.

https://es.wikipedia.org/wiki/Modelo_relacional
Jerárquicas
En ellas se organiza la información se organiza con un jerarquía en la que la relación entre las entidades de este modelo siempre es del tipo padre / hijo. De esta forma hay una serie de nodos que contendrán atributos y que se relacionarán con nodos hijos de forma que puede haber más de un hijo para el mismo padre (pero un hijo sólo tiene un padre).
Las entidades de este modelo se llaman Las entidades de este modelo se llaman segmentos y los atributos campos. La forma visual de este modelo es de árbol invertido, en la parte superior están los padres y en la inferior los hijos.
Suscribirse a:
Entradas (Atom)